业务环境
项目背景
该公司智慧服务已进驻全国多个城市,服务上百万户业主,数据中心作为核心保障部门面临较大挑战。现有运维处于工具化阶段:基础硬件设备主要通过基础网管、动环等手段监控,应用内部程序则以 APM 为主要监控手段。
需要解决的问题
用户痛点
排查故障时各部门需要分别查看自身监控,缺乏一体化视角,难以界定问题点;互联网和分支办公区专线访问数据中心的链路质量只能通过基础网管观察流量,无法评估流量质量和定位突发业务;公有云内部虚拟机之间的互访关系与应用质量难以评估,故障发生后无法快速定位。
跨部门排障难界定问题点
专线质量无法精细评估
公有云内部调用关系不清
围绕真实业务建设
建设内容
统一监控分析视图
链路质量监控
全局调用关系视图
来自案例集的实际界面与描述
应用场景
- 01
统一监控分析视图
在数据采集层汇聚网络流量、基础网管、应用性能等数据,通过原始网络数据包和 API 对数据分类入库,并在可视化界面中配置现有监控工具接口。计算内容覆盖应用层的建连时间、响应时间、成功率,网络层的吞吐量、丢包率、网络时延,会话层的建连请求数、失败率、服务端重置,以及主机层的 CPU、内存、磁盘 I/O 使用率。通过对数据中心入口及沿途节点统一分析,形成一体化监控视图,缩短故障域排查时间。
- 02
链路质量监控
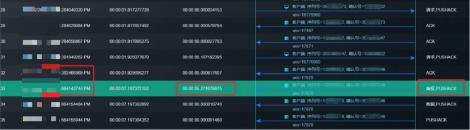
相关线路通过 SPAN 方式采集数据,以精细根因指标评估链路质量,网络异常时快速定位故障区域。监控不仅包含流入流出吞吐量,还包括客户侧时延、服务侧时延、客户侧丢包、服务侧丢包、连接状态和响应时间。链路用量和质量可自动生成报告,呈现峰值指标和波动趋势。
- 03
全局调用关系视图
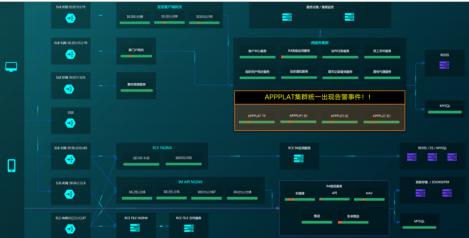
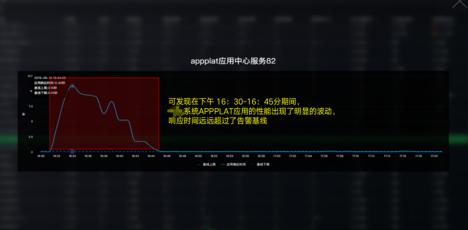
阿里云内部监控采用部署 Agent 的方式开展端到端分析。全局调用关系视图清晰呈现网关服务、底层服务、微服务集群等节点区域健康状态,各节点关联告警,触发后通过颜色变化提示。点击可查看告警详情及关联数据波动;锁定故障范围后可进一步分析应用响应时间突增,并判断问题是否由应用自身导致、是否受网络和主机影响。该类问题可在少于五个步骤内完成定位。
从数据到判断
分析过程
- 01
汇聚网络流量、基础网管和应用性能数据
- 02
通过数据包与 API 分类接入
- 03
围绕数据中心入口和沿途节点统一分析
基于案例材料整理
应用价值
形成网络、应用、会话和主机的一体化监控视图
缩短故障域排查时间
案例中同类问题可在少于五个步骤内完成定位
对应案例集第 41–43 页,保留原始章节与图表。