
在半导体显示面板制造行业,产线一旦停摆,影响的不只是一个设备:半成品可能报废,上下游排产可能被打乱,运维与生产人员也要投入大量时间排查。随着 LCD、OLED 产线自动化程度不断提高,机械臂、AGV、EIS 设备接口系统和 MES 制造执行系统对工业网络的依赖越来越深。
更棘手的是,有些故障只持续约10秒,随后自动恢复。它既不触发传统网管告警,也不一定留下明显的设备状态异常,却足以让一条产线短暂停转。某半导体显示面板制造企业就曾反复遇到这样的“幽灵故障”。
01 机械臂突然停住,约10秒后自行恢复
每年年底的“迎峰赶产”是半导体企业的关键考验。订单集中、产线高负荷运行,任何微小波动都可能被放大。对这家企业的 IT 运维团队来说,真正难以定位的问题,隐藏在工业网络链路的瞬时变化中。
一天,产线机械臂突然停住,整条流水线随之暂停;约10秒后,设备自行恢复。
网管系统没有告警,交换机状态也显示正常。类似现象此后仍会重复出现:产线终端 PC 突然离线,无法连接 EIS 服务器,过一段时间又恢复。故障短暂、随机、难以复现,IT 与生产团队多次联合排查,却始终缺少能够还原现场的证据。
02 传统监控为何难以识别偶发故障?
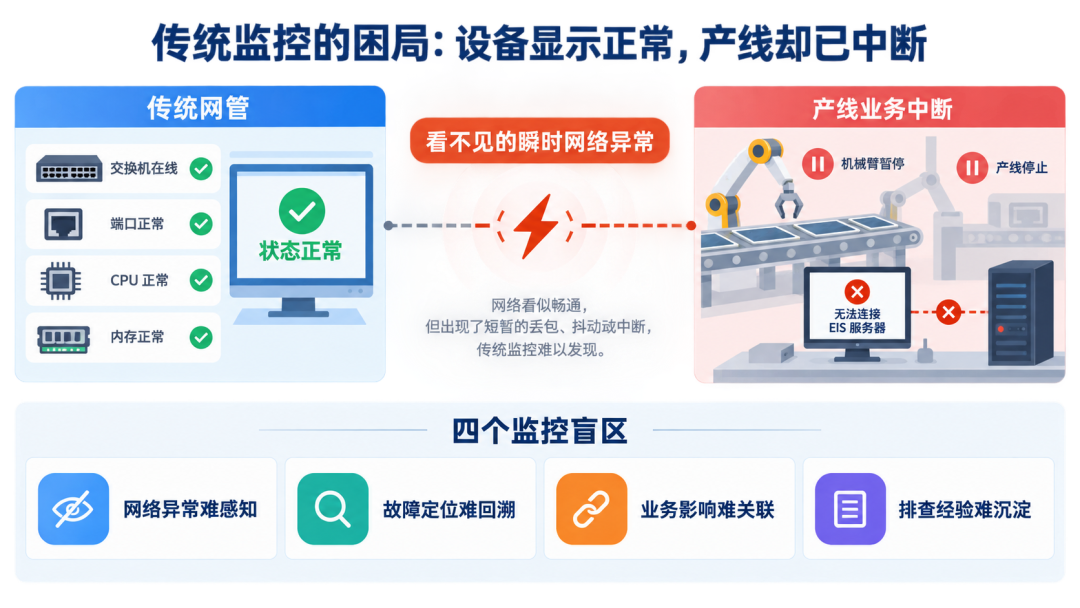
在引入智维数据网络流量分析平台前,该企业主要依靠传统网管和人工巡检。传统监控可以看到设备在线状态、端口、CPU、内存等资源指标,但无法回答三个关键问题:故障发生时,链路上具体传输了什么?哪一跳出现了异常?它影响了哪一项生产业务?
面对偶发故障,传统监控主要有四个盲区。
第一,设备“正常”不等于业务通信正常。只要设备在线、资源未耗尽,监控往往显示正常;但异常抖动、链路丢包、协议握手失败等瞬时问题,可能已经影响产线设备。
第二,故障发生后难以回到现场。没有全流量留存和跨节点关联,运维人员只能在分散日志中寻找某一次失败请求,线索经过核心、接入、终端等多个节点后容易中断。
第三,技术异常与生产影响之间缺少映射。即使发现某个网络节点异常,也很难立即判断它是否影响某条产线、某类设备或某个关键业务连接,故障处置优先级因此难以确定。
第四,排查过程依赖个人经验。跨节点比对、协议层下钻和根因推理没有形成标准化路径,换一名工程师或换一条产线,类似问题仍可能从头排查。
在该企业,偶发中断反复出现。资深工程师只能凭经验判断“可能是设备问题”或“可能是终端问题”,但始终缺乏完整证据链。生产部门说“就是连不上”,网络侧说“设备状态正常”,问题在部门之间来回流转。
03 用全流量回溯还原故障现场
针对半导体制造场景,智维数据为该企业部署网络流量分析方案:在北京大兴、房山和合肥三个数据中心部署 7 台流量探针,集中管理并统一分析,覆盖 54 个关键镜像节点、162 条网络链路和 904 个应用。
第一步是回溯分析。平台对核心交换机、接入交换机等多个节点进行流量镜像,并按故障时间窗口进行跨节点比对。分析发现,异常连接均由产线终端发起;进一步比对接入侧与核心侧流量后,确认故障时段未捕获到终端发出的请求包。随后,平台从近一天的 ARP 流量中发现异常周期,与机械臂停工时间高度吻合。
第二步是协议级解析。下钻 ARP、会话和端口扫描等协议特征后,分析发现:终端网关 MAC 失效,交换机 ARP 响应时延升高;同时,内网存在异常端口扫描和疑似受感染主机行为。
最终根因被定位为:一批使用年限较久的产线终端 PC 感染蠕虫病毒,在内网大量发送 ARP 请求,形成 ARP 泛洪;部分受感染终端还存在端口扫描行为,进一步拖慢交换机的 ARP 响应。故障链路是:终端网关 MAC 失效后反复发起 ARP 请求,交换机响应变慢;EIS 服务器与 CELL 产线终端之间的长连接超时约为10秒,通信一旦遇到 ARP 响应延迟,就会断开。最终表现为机械臂偶发停工约10秒、产线 PC 掉线以及无法连接 EIS 服务器。
一次排查,沉淀一套可复用的方法
这次故障说明,全流量采集解决了“现场不可回放”的问题,协议级分析则帮助团队把网络现象串成业务根因。但复盘也暴露出另一个挑战:从跨节点回溯、协议下钻到根因推理,仍然依赖参与排查工程师的经验。如何把这条路径沉淀为可复用、可传承的分析能力,成为后续建设重点。
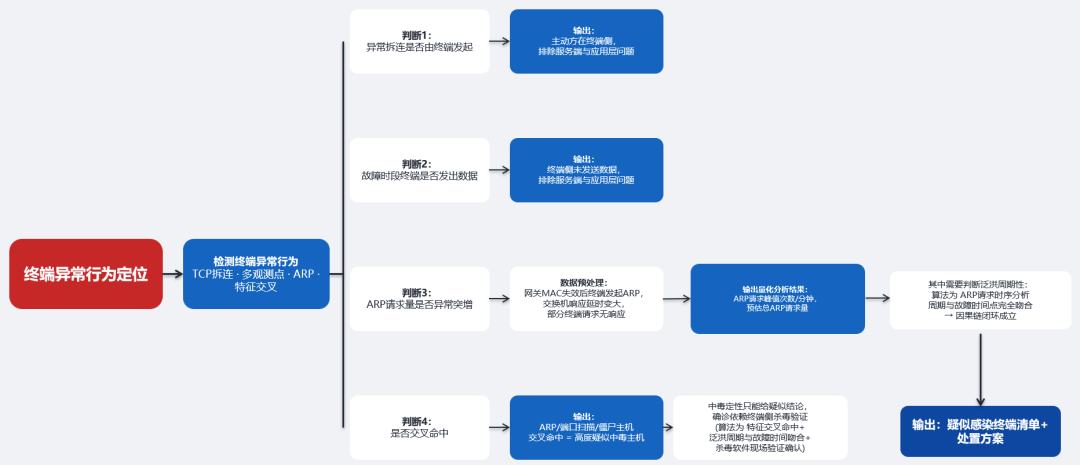
异常终端行为分析方法论
04 让数据支撑产线稳定运行
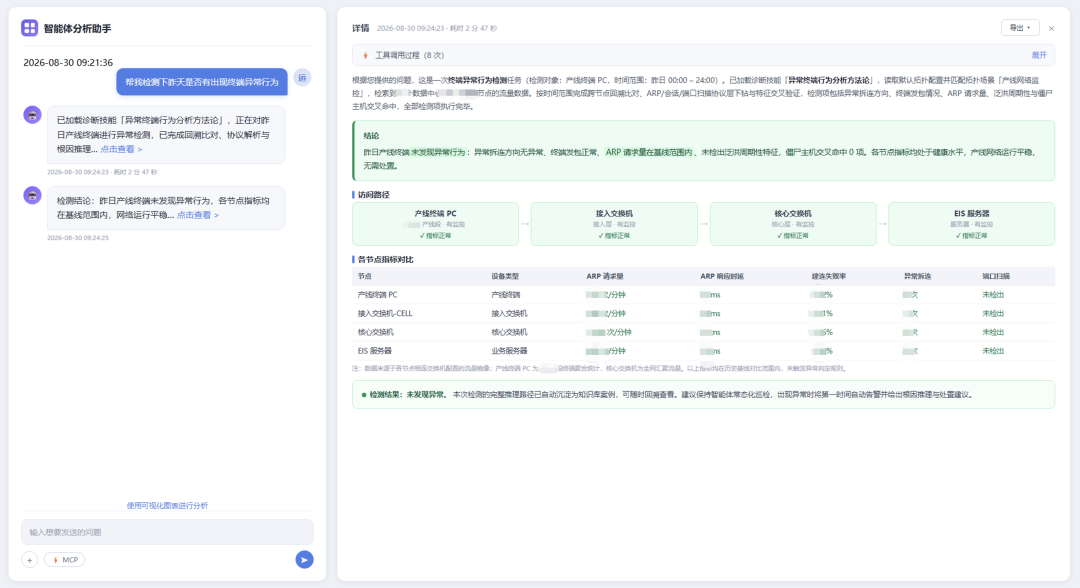
基于本次案例,智维数据将“时间窗口回溯—跨节点关联—协议层下钻—根因推理”的排查路径进行沉淀,并结合产品迭代和 AI 大模型能力,支持通过自定义 Skill 与智能体开展场景化分析。目标是让运维工作从“故障发生后被动救火”,逐步走向“基于证据的快速定位与主动发现”。
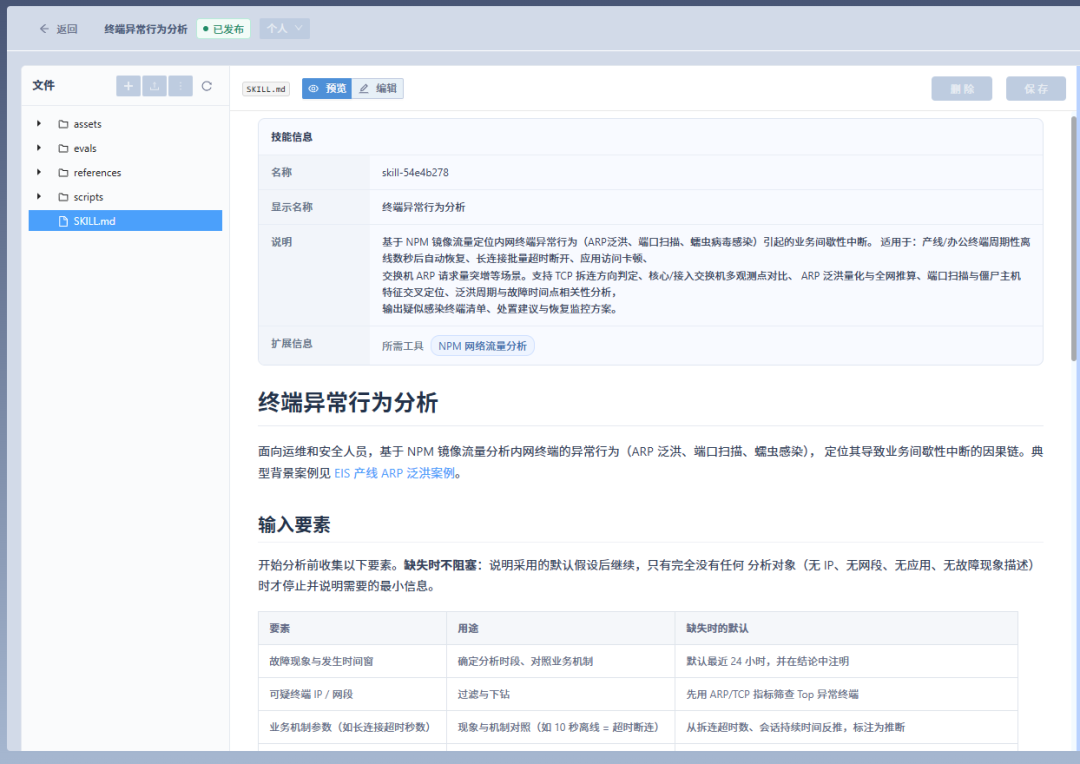
自定义 Skill:按业务场景形成专属分析能力
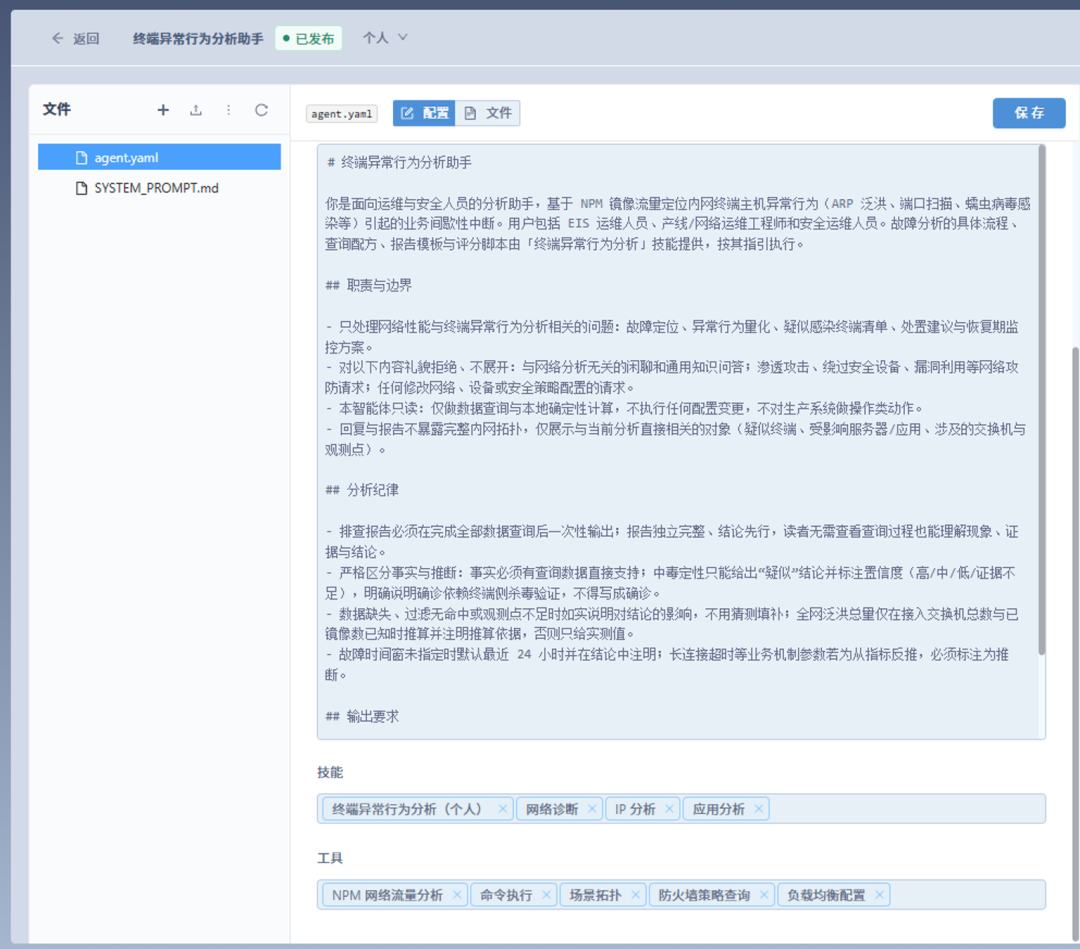
自定义智能体:按运维任务编排分析流程,提高诊断效率与一致性
1. 从人工跨节点比对,到自然语言驱动的智能回溯。过去,工程师需要在网管、SNMP 告警平台、交换机 CLI、终端管理和安全控制台之间切换,按时间窗口手动拉取并比对数据。现在,运维人员可用自然语言提出“昨天下午3点产线网络有什么异常”等问题,由智能体协助关联时间窗口、异常节点、网络拓扑和影响范围,并提示类似“异常连接由产线终端发起”等关键线索。最终结论仍由工程师审核确认。
2. 从人工拆包下钻,到数据包分析助手辅助解析。过去,协议分析需要工程师手工抓包,逐项检查 ARP、会话和端口扫描等特征。现在,数据包分析助手可以辅助完成拆包、协议识别和异常特征提取,并围绕“网关 MAC 失效—ARP 响应延迟—异常终端行为”等线索生成初步判断与排查建议,减少重复性分析工作。
3. 从依赖个人经验,到智能体生成可审阅的根因推理链。智能体可以将 ARP 泛洪、端口扫描、网关 MAC 失效和长连接超时等证据关联起来,形成结构化的因果链与处置建议。每次分析过程和结论还可沉淀为知识库案例,为后续相似故障提供检索和比对依据。
当故障证据能够被统一采集、关联和复盘,生产与 IT 团队就不必再围绕“到底是不是网络问题”反复争论,而是可以围绕同一条证据链协同处置。
在这家半导体企业,全流量采集首先解决了“看得见”的问题:让短暂故障有迹可循,让网络异常能够与具体业务影响建立联系。这次约10秒停摆案例也推动了产品分析能力的沉淀——把一次依赖资深工程师经验的排查过程,逐步转化为平台内可复用、可审阅的回溯、解析和根因分析流程。
AI 大模型深度融合分析
全流量为故障留下证据,AI 则帮助运维人员更快理解证据、发现关联。对高自动化的半导体产线而言,这意味着网络运维有机会从“故障后定位”,进一步走向“异常提前发现”。